Guía práctica · Equipos de Argentina
Automatización de pruebas: estrategia antes que scripts
Automatizar bien ahorra horas de regresión. Automatizar mal suma mantenimiento y frustración. Esta guía ayuda a equipos argentinos a decidir qué automatizar, con qué herramientas y cómo mantenerlo vivo dentro de sprints reales.
Con ejemplos para tiendas online, sistemas administrativos y apps móviles. Sin promesas de cobertura total. Con criterio para que la inversión se note en cada release.
Pruebas de regresión automatizadas · Estrategia de automatización QA · CI testing Argentina
Regresión repetitiva
Red para lo que sostiene el negocio.
APIs primero
Rápidas, estables, con poca gente.
Datos aislados
Staging estable con reseteo.
Pipeline vivo
Corta en cada pull, completa de noche.
Mantenimiento asignado
Sin dueño semanal, la suite muere.
Criterio de base
Para qué sirve y para qué no
Pensá la automatización como una red de seguridad para los flujos que sostienen el negocio. Brilla cuando la tarea es repetitiva: verificar que lo que andaba siga andando después de cada cambio.
Regla de QA Tech Argentina
Si tu producto cambia de interfaz cada sprint, primero estabilizá y después automatizá lo que quede fijo. Automatizar pantallas en movimiento es pagar dos veces.
Dónde rinde la automatización
Regresión de flujos críticos: login, compra, facturación y sincronización que se prueban en cada release.
Chequeos de API y de datos que no dependen del diseño visual y cambian poco entre sprints.
No sirve para descubrir errores nuevos de usabilidad ni para validar diseños que cambian cada semana. Tampoco reemplaza el juicio del tester.
No la uses para reportes con filtros inestables o integraciones externas que fallan por causas ajenas al código.
Red de seguridad · No exploratorio · No juicio manual
Prioridades para equipos chicos
Qué automatizar primero
Elegí pruebas estables, críticas y repetitivas. Una regla práctica para equipos chicos de Argentina: si una prueba manual te toma 10 minutos y la corrés cada semana, automatizarla paga en pocos meses. Si la corrés una vez por trimestre, no.
Tienda online
Login, registro, búsqueda y compra básica.
Sistema administrativo
Alta, edición y baja en ABM central.
App móvil
Instalación, login y sincronización inicial.
Dejar para después
Reportes con muchos filtros y PDFs con diseño fino.
Evitar al inicio
Integraciones externas inestables y pasarelas reales.
Medida simple
Frecuencia semanal más criticidad define el orden.
Frameworks de testing en uso local
Herramientas más usadas en el país
No hay una ganadora universal. Evaluá qué sabe mantener tu equipo después del arranque.
Web y frontend moderno
Selenium, Cypress y Playwright
En avisos locales vas a ver Selenium con Java o Python, Cypress para frontend moderno y Playwright que crece rápido por su estabilidad y su modo de espera automática. Si tu frontend es React con despliegues frecuentes, Cypress o Playwright suelen integrarse más rápido. Si ya tenés base en Selenium, no la tires sin motivo: migrar todo de golpe suele costar más que ordenar lo que ya corre.
Móvil y APIs
Appium, Postman y scripts simples
Para móvil, Appium sigue presente en equipos que prueban en varios modelos. Para APIs, Rest Assured, Postman con Newman o scripts simples en Python cubren creación, consulta y borrado sin la fragilidad de la interfaz. Elegí según el lenguaje que tu equipo ya lee cada día, porque esa es la suite que van a cuidar.
¿Dudás entre dos herramientas? Probalas una semana con tus propios casos de login y compra, no con demos genéricas.
Comparar dudas comunes
Estructura que no se rompe a la semana
Usá patrón Page Object o similar, localizadores estables con data-testid en vez de XPaths frágiles, datos de prueba aislados y limpieza después de cada corrida. Una suite ordenada se entiende sin que el autor la explique.
Separá configuración por ambiente: desarrollo, staging y producción espejo. Guardá secretos fuera del repositorio. En proyectos con facturación local, creá usuarios y productos de prueba con CUIT y precios ficticios pero válidos en formato, para que las validaciones corran como en la vida real.
Localizadores con data-testid y nombres que describen la acción, no la posición.
Usuarios y productos de prueba creados y borrados por el propio script.
Secretos y claves fuera del repo, por variables de ambiente.
Convenciones que dejamos por escrito
Nombres de archivos por flujo, una carpeta por ambiente, y una guía de una página que explica cómo agregar una prueba sin romper las demás.
Incluí estrategia de ramas y criterio de cuarentena: cuando una prueba falla por causa externa se marca, se aísla y se revisa, no se deja en rojo eterno.
Borde perforado y regla verde bajo cada placa de foto.
Integración continua para equipos reales
Que las pruebas corran solas
Conectá las pruebas al pipeline. Con GitHub Actions o GitLab CI podés correr la regresión corta en cada pull request y la completa cada noche. Publicá el reporte donde el equipo lo mire: en el mismo merge request o en Slack.
Configurá reintentos limitados solo para fallos por red, no para esconder inestabilidad. Si la suite tarda más de 15 minutos para el flujo crítico, dividila. Nadie espera una hora para mergear un cambio chico un viernes a la tarde.
En cada cambio
Regresión corta y rápida.
Cada noche
Suite completa con datos frescos.
En el merge
Resultado visible sin buscar.
Datos y ambientes de prueba
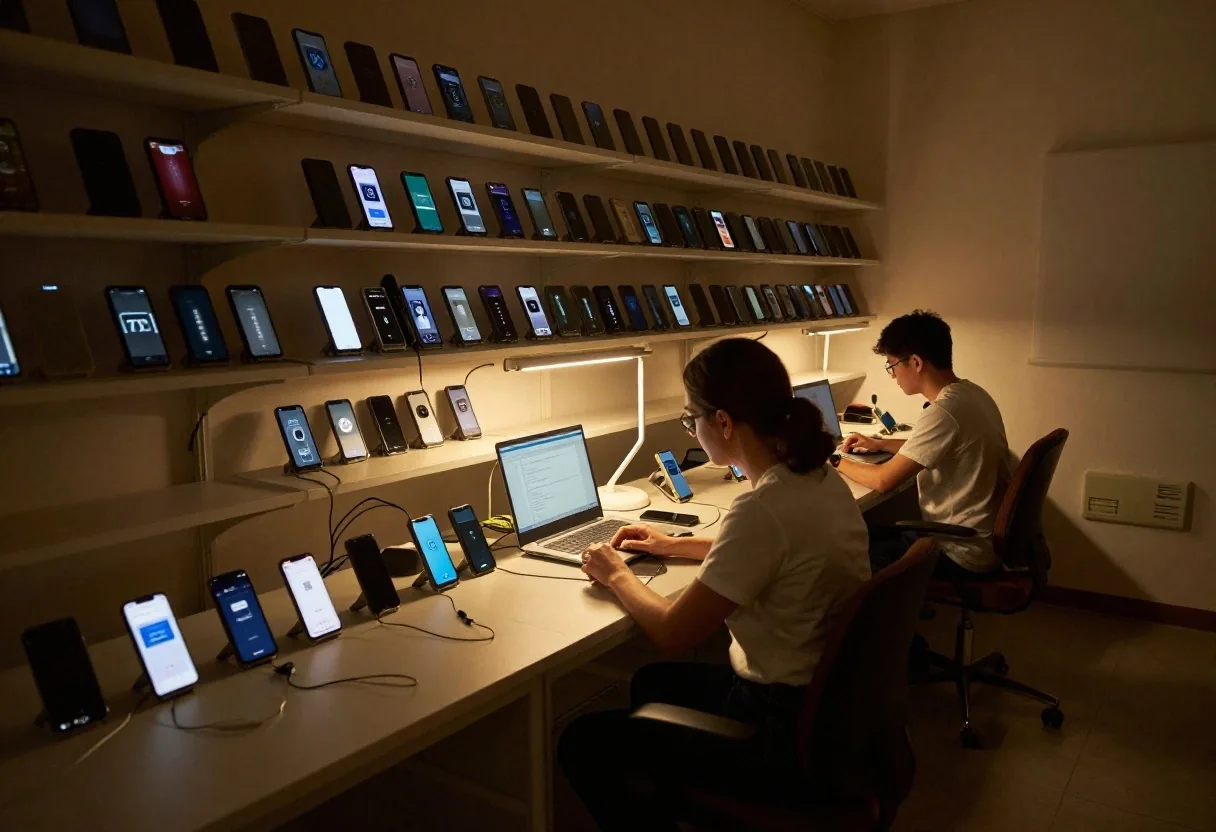
La mayoría de las fallas no son del script, sino de datos que cambiaron. Reservá un staging estable, con juegos conocidos y reseteo programado. Evitá depender de servicios externos reales; usá mocks o sandboxes de pago.
Documentá cómo crear un usuario válido en un minuto. Si comparten un solo servidor de prueba, coordinen corridas nocturnas para no pisarse con pruebas manuales.
Costos honestos
Mantenimiento y costos honestos
Toda suite necesita mantenimiento cuando cambia el producto. Calculá entre 10 y 30 por ciento del tiempo de desarrollo de la feature para ajustar pruebas, según cuánto cambie la interfaz.
Si nadie tiene horas asignadas para mantener, la automatización muere. Asigná un responsable por semana, rotativo si el equipo es chico. Borrá pruebas que ya no aportan. Una suite de 30 pruebas verdes y útiles vale más que una de 300 que nadie mira porque la mitad falla por datos viejos.
Atajo con pocos recursos
Automatización de APIs como atajo
Si tenés pocos recursos, empezá por APIs. Son más rápidas y estables que la interfaz. Verificá creación, consulta, modificación y borrado, validaciones de campos y códigos de error.
Para un backend típico con endpoints de usuarios, productos y pagos, una colección bien armada detecta regresiones antes que la interfaz. Después sumás unas pocas pruebas end-to-end por UI para el camino crítico. Esa combinación rinde mucho con poca gente.
Para no tropezar
Errores que frenan a muchos equipos
Cada uno tiene solución simple, pero hay que decidirla antes de grabar el primer script. Dejá por escrito convenciones, ramas y cuarentena.
Ver servicios de automatizaciónQuerer automatizar todo el primer mes
Empezá con 15 a 25 pruebas críticas y ampliá cuando la base esté verde.
Grabar scripts sin estructura
Sin Page Object y datos aislados, el mantenimiento se vuelve imposible.
Depender de pausas fijas
Usá esperas inteligentes que aguardan el estado real, no segundos a ciegas.
Correr todo contra producción
Usá staging espejo y sandboxes para no tocar datos reales.
No versionar los datos
Guardá juegos de datos con el código y resetealos en cada corrida.
Probar solo en una máquina
Corré en pipeline y en otro equipo para atrapar dependencias locales.
Apoyo puntual
Cuándo pedir ayuda externa
Conviene apoyo externo para montar la base, elegir herramienta y dejar el pipeline corriendo. Después tu equipo lo mantiene con sus propios casos.
En Servicios QA hacemos ese arranque y capacitamos con tus propios flujos, no con ejemplos genéricos. Si ya tenés suite pero es inestable, hacemos una auditoría de las fallas más frecuentes y proponemos un plan de estabilización en dos o tres sprints.
QA Tech Argentina es una guía independiente y de servicios para el mercado tecnológico argentino. Contanos tu stack y cuántas pruebas tenés hoy para orientarte sin compromiso. Atendemos de lunes a viernes de 9:00 a 18:00 en Av. Corrientes 1233, Buenos Aires.
Qué contar al pedir detalles
- —
Lenguaje y framework actual, si hay alguno en uso.
- —
Cantidad de pruebas y dónde fallan más seguido.
- —
Ambientes disponibles y cómo se crean los datos.
Contacto: [email protected] · +54 11 4326 7890
Cierre de criterio
Treinta pruebas verdes y útiles rinden más que trescientas que nadie mira.
Preguntas frecuentes
Dudas que escuchamos seguido
Respuestas cortas para decidir por dónde empezar. Para casos puntuales, escribinos con tu stack.
¿Necesito saber programar para automatizar?
Para mantener suites en código sí, al menos nivel básico del lenguaje del proyecto. Para empezar hay opciones de bajo código que sirven para explorar, pero para una regresión estable conviene código versionado que el equipo pueda leer, revisar y correr en el pipeline.
¿Cuánto tarda ver beneficios?
Una base pequeña de 15 a 25 pruebas críticas suele mostrar ahorro desde el segundo o tercer ciclo de regresión, si el ambiente es estable. El ahorro aparece cuando dejás de probar a mano lo mismo cada semana y la suite corre sola de noche.
¿Por dónde empiezo si somos pocos?
Empezá por APIs de usuarios, productos y pagos, y sumá solo el camino crítico por interfaz. Esa combinación detecta regresiones temprano sin pedir un equipo grande ni una suite enorme para mantener.